
Moteur de recherche : définition et fonctionnement
En une phrase
Un moteur de recherche est un service qui retrouve, parmi des milliards de pages web, celles qui répondent le mieux à ce qu’on lui demande. Il ne cherche pas sur le web au moment où vous tapez : il cherche dans une copie du web qu’il a constituée à l’avance.
En bref
- Le moteur explore le web à l’avance, le range dans un index, et interroge cet index à chaque recherche.
- Quatre opérations : explorer, indexer, classer, afficher. Le référencement agit sur les trois premières.
- En France, Google pèse près de neuf recherches sur dix — mais il recule doucement.
- Un moteur n’est pas un navigateur, et ce n’est plus seulement une liste de liens.
Les quatre opérations, et ce qu’elles changent pour vous
1. Explorer. Des programmes appelés robots parcourent le web de lien en lien et lisent le code des pages. Le métier dit qu’ils « crawlent ». Ils reviennent d’autant plus souvent qu’un site bouge et qu’on parle de lui.
Ce que ça implique : une page qu’aucun lien ne désigne, ni depuis votre site ni depuis un autre, peut ne jamais être découverte. C’est le premier rôle du maillage interne.
2. Indexer. Ce qui a été lu est analysé puis rangé dans une immense base de données : l’index du moteur. Une page explorée n’est pas forcément indexée — le moteur peut estimer qu’elle n’apporte rien, ou qu’elle répète une page déjà connue.
Ce que ça implique : tant qu’une page n’est pas dans l’index, elle est introuvable, quel que soit son contenu. C’est le premier point à vérifier quand un site « n’apparaît pas dans Google », et la Search Console le dit gratuitement.
3. Classer. Quand quelqu’un tape un mot-clé, le moteur interroge son index et ordonne les pages retenues selon des centaines de critères : l’adéquation du contenu à la demande, la clarté de la page, sa vitesse, les liens qui pointent vers elle, la réputation du site.
Ce que ça implique : c’est ici que se joue l’essentiel du référencement naturel. Les deux étapes précédentes sont des conditions d’entrée ; celle-ci est la compétition.
4. Afficher. Le résultat s’affiche dans une page de résultats. Elle n’est plus la liste de dix liens bleus d’il y a quinze ans : on y trouve des annonces, des cartes, des images, des extraits mis en avant, et de plus en plus souvent un aperçu rédigé par une intelligence artificielle.
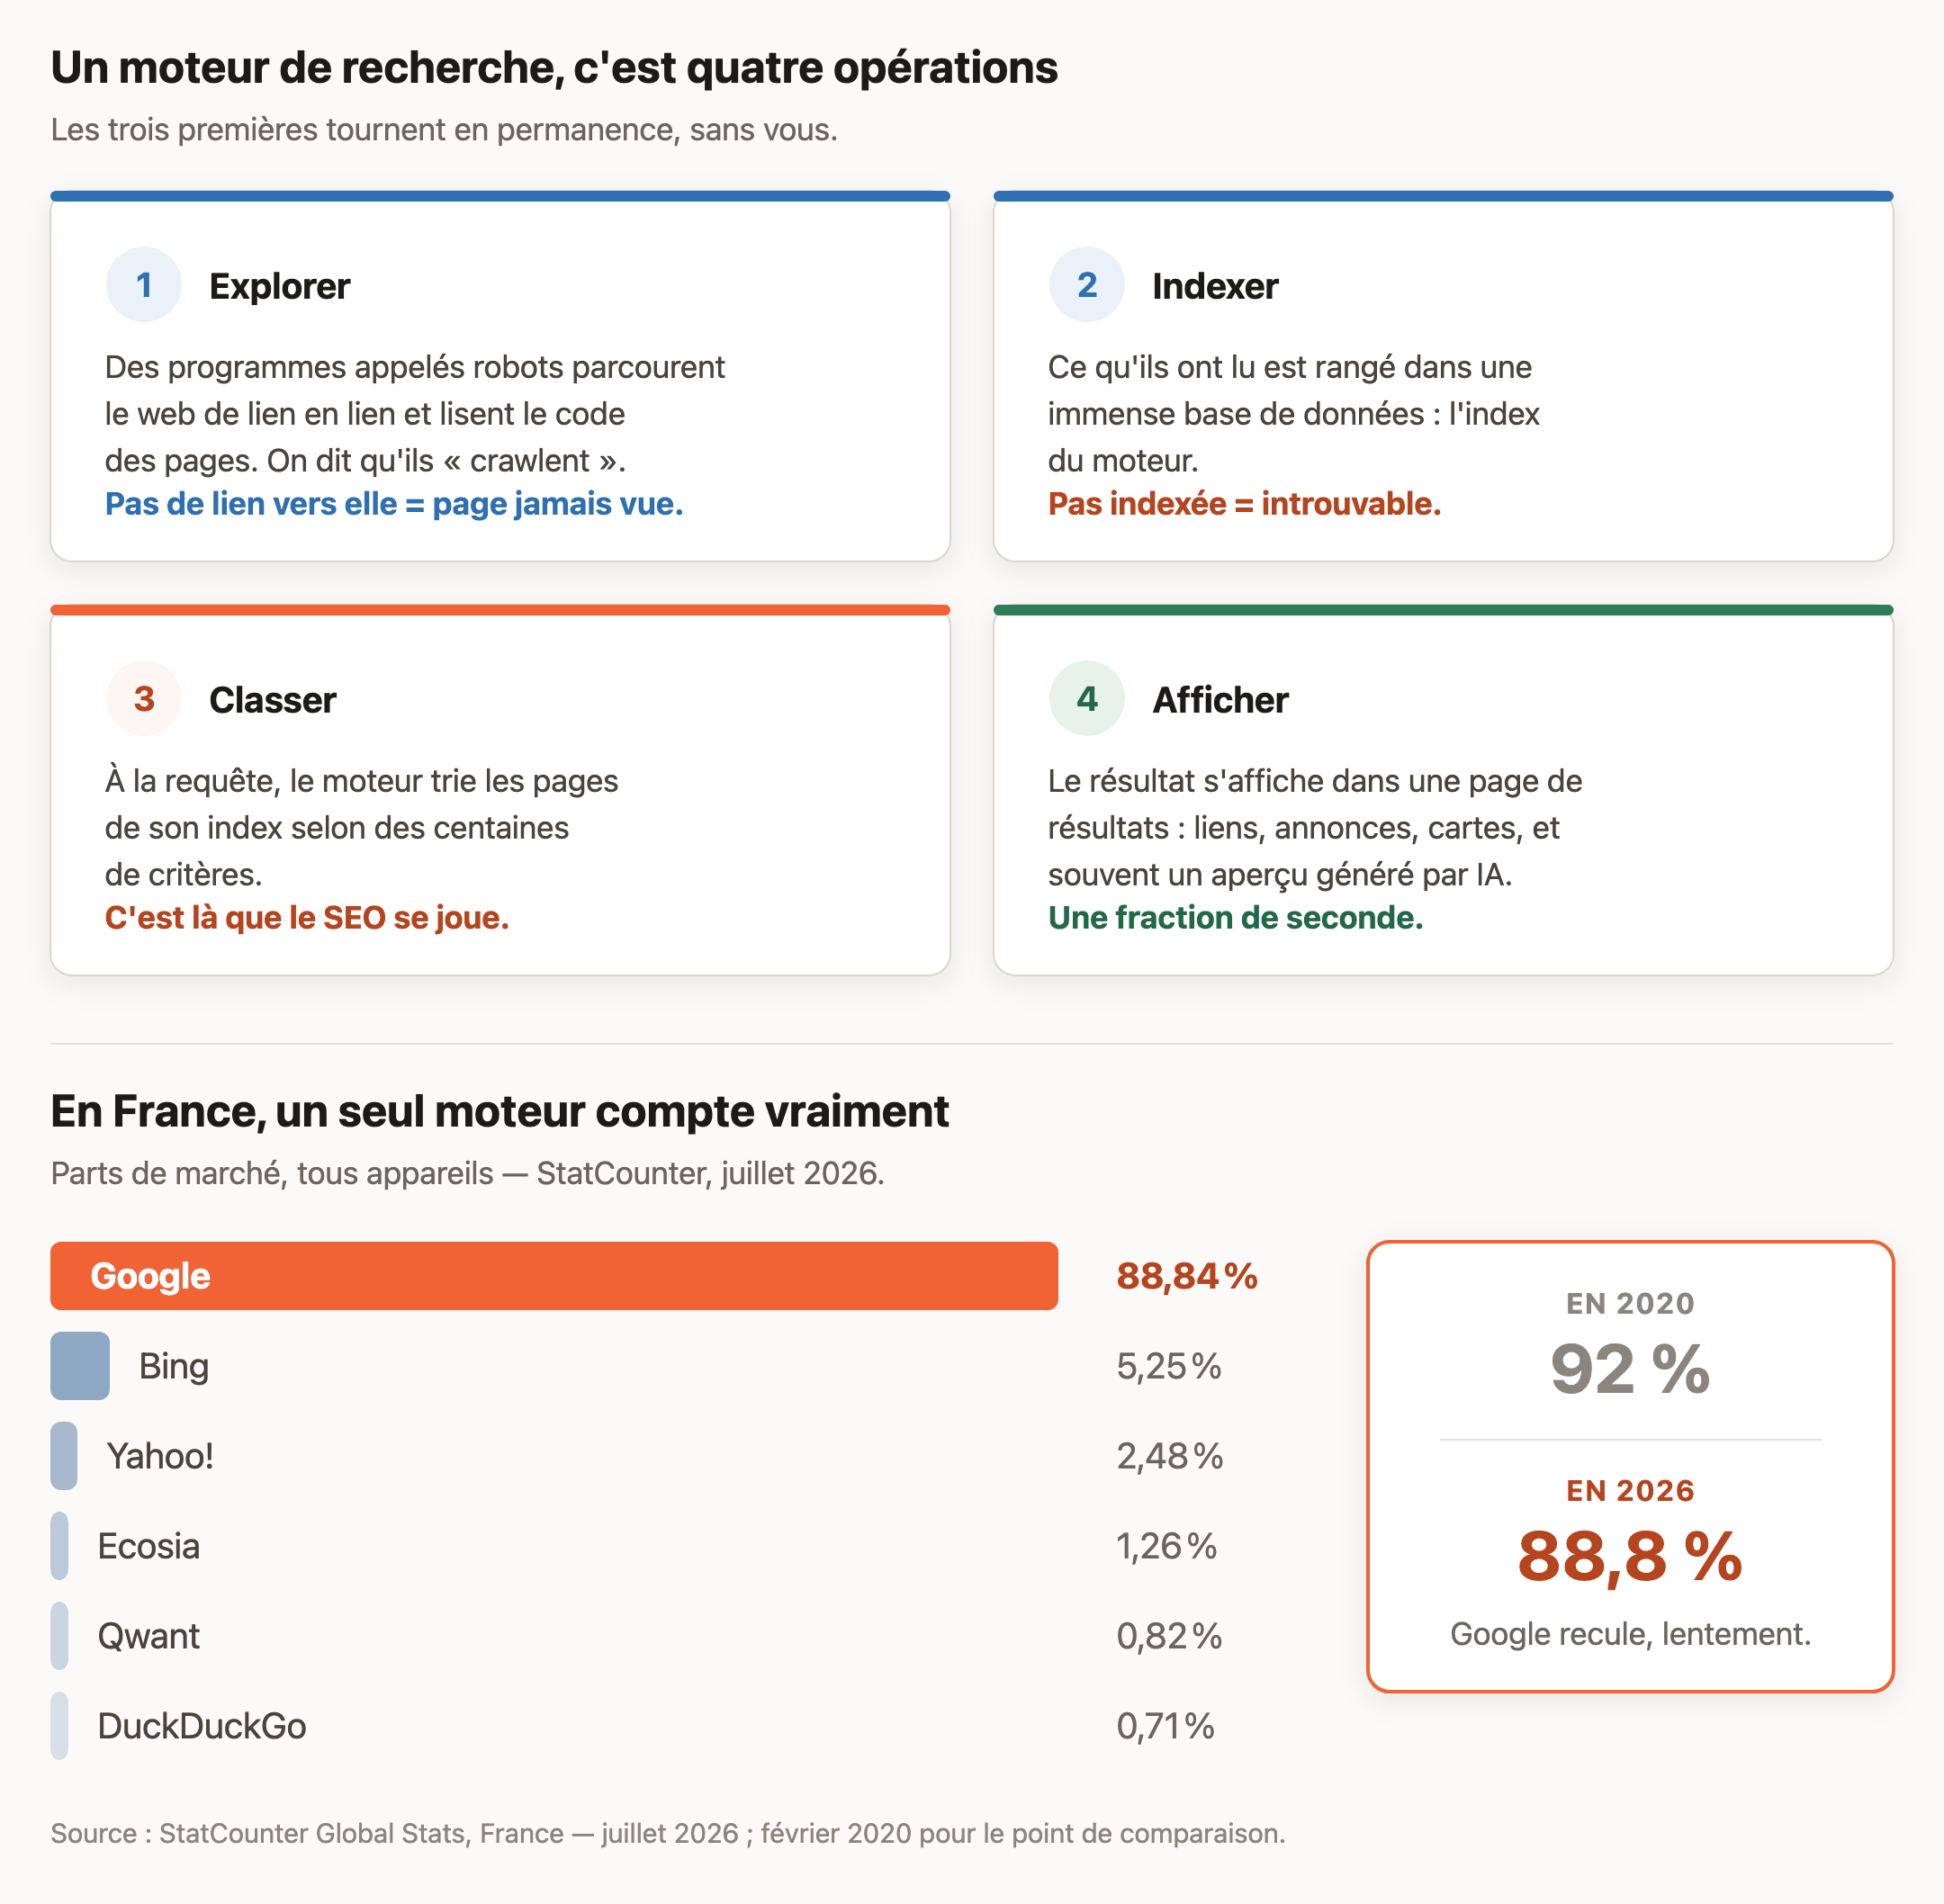
Les trois premières opérations tournent en permanence, sans vous. La quatrième dure une fraction de seconde.
Le paysage français en 2026
D’après StatCounter, Google représentait 88,84 % des recherches faites en France en juillet 2026, tous appareils confondus. Derrière, l’écart est vertigineux : Bing à 5,25 %, Yahoo! à 2,48 %, Ecosia à 1,26 %, Qwant à 0,82 % et DuckDuckGo à 0,71 %.
Le chiffre intéressant n’est pas le niveau, c’est la tendance. Quand j’ai écrit la première version de cette fiche, la même mesure donnait environ 92 % à Google. Le recul est lent, mais il est réel — et il ne profite pas à un concurrent en particulier : il se disperse entre plusieurs petits moteurs. Et ces statistiques ne mesurent que les moteurs : les questions posées à un assistant conversationnel n’y figurent pas du tout.
Un mouvement de fond mérite d’être signalé : en novembre 2024, Qwant et Ecosia ont créé une coentreprise, European Search Perspective, pour construire leur propre index européen et cesser de dépendre de celui de Microsoft. Depuis août 2025, cet index sert de vraies requêtes. À l’échelle des parts de marché ci-dessus, ça ne change rien ; à l’échelle de la décennie, c’est la première tentative sérieuse de construire un index alternatif en Europe.
Ce que j’en dis à mes clients : travailler pour Google reste la priorité évidente en France, et le restera un moment. Mais vérifier qu’on est correctement indexé par les autres ne coûte presque rien, et ferme beaucoup moins de portes.
Ce qui a changé : le moteur qui répond
Pendant vingt ans, un moteur de recherche faisait une chose : proposer des liens, à charge pour vous d’aller voir. Ce n’est plus vrai. Google répond de plus en plus souvent lui-même, en haut de la page, à partir de ce qu’il a lu sur les sites — sans que l’internaute ait besoin de cliquer.
Pour donner une idée : sur les quatre recherches que j’ai testées en août 2026 en préparant ces fiches, un aperçu généré par IA s’affichait à chaque fois. Quatre recherches, ce n’est pas une étude ; c’est un relevé, et il va dans le même sens que ce que je constate en clientèle.
La conséquence est double. Être bien classé ne suffit plus toujours à recevoir la visite : si la réponse tient dans l’aperçu, personne ne descend. Mais une nouvelle place s’ouvre : être la source que le moteur cite dans sa réponse. C’est un travail voisin du référencement classique, avec ses propres règles — c’est l’objet de mon accompagnement en visibilité dans les IA.
Trois choses qu’on prend pour un moteur de recherche
Le navigateur. Chrome, Safari, Firefox, Edge : ce sont des logiciels qui affichent des pages web. Le moteur est le service qu’ils interrogent. La confusion est entretenue par le fait que la barre d’adresse du navigateur sert aussi de barre de recherche.
L’annuaire. Un annuaire web classe des sites dans des rubriques, à la main, sur candidature. Un moteur explore automatiquement, page par page, sans qu’on lui demande rien. Les annuaires généralistes ont pratiquement disparu.
Le moteur interne d’un site. Le champ « rechercher » d’une boutique en ligne ne cherche que dans cette boutique. Il n’a rien à voir avec Google — mais il mérite qu’on s’y intéresse, parce que ce que les visiteurs y tapent est une mine de mots-clés.
Les erreurs fréquentes
- Croire que le moteur cherche sur le web en direct. Il cherche dans son index, constitué à l’avance. D’où le délai entre une publication et son apparition.
- Confondre « pas indexé » et « mal classé ». Ce ne sont pas les mêmes problèmes ni les mêmes remèdes.
- Bloquer une page pour la faire disparaître des résultats. Si le robot ne peut plus la lire, il ne peut plus lire la consigne de retrait non plus.
- Ne jamais vérifier qu’on est indexé ailleurs que chez Google. Le contrôle prend cinq minutes et se fait une fois.
Cette fiche fait partie du dico du référencement. Voir aussi : SERP, robot d’indexation et référencement naturel.
Questions fréquentes
Comment fonctionne un moteur de recherche, simplement ?
En quatre opérations. Des robots parcourent le web et lisent les pages ; ce qu’ils lisent est rangé dans une base de données appelée l’index ; à chaque recherche, le moteur trie les pages de son index selon des centaines de critères ; puis il affiche le résultat dans une page de résultats.
Quelle différence entre un moteur de recherche et un navigateur ?
Le navigateur est le logiciel installé sur votre ordinateur — Chrome, Safari, Firefox. Le moteur de recherche est un service auquel il vous donne accès. On peut changer de moteur sans changer de navigateur, et l’inverse.
Quels sont les moteurs de recherche les plus utilisés en France ?
Google très largement devant, avec près de neuf recherches sur dix. Bing arrive loin derrière, puis Yahoo!, Ecosia, Qwant et DuckDuckGo, chacun sous les 3 %. Ces chiffres sont ceux de StatCounter pour juillet 2026.
Faut-il optimiser son site pour Bing ou pour Qwant ?
Rarement à titre principal, vu leurs parts de marché en France. Mais le travail se reporte largement : un site bien construit pour Google l’est pour les autres. La vraie question n’est pas d’optimiser pour eux, c’est de vérifier qu’ils vous connaissent : être absent de l’index de Bing, par exemple, ferme plusieurs portes à la fois.
Mon site n’apparaît pas dans Google : pourquoi ?
Trois causes possibles, dans l’ordre où il faut les vérifier. Le robot n’a pas pu explorer la page ; il l’a explorée mais ne l’a pas indexée ; ou elle est indexée mais classée trop loin pour être vue. La Search Console de Google répond à la question en quelques clics, gratuitement.
Un moteur de recherche et un annuaire, c’est pareil ?
Non. L’annuaire classe des sites dans des catégories, à la main. Le moteur explore automatiquement le web page par page. Les annuaires généralistes ont pratiquement disparu ; le mot survit surtout dans le vocabulaire du référencement.