Accueil›Ressources›Dico du référencement
Dico du référencement
Robot d’indexation : définition (spider, crawler, bot)
par Olivier Corneloup · Mis à jour en octobre 2026
En une phrase
Un robot d’indexation (on dit aussi crawler, spider ou bot) est un programme qui parcourt le web en permanence, de lien en lien, pour lire les pages et les transmettre au moteur de recherche qui les rangera dans son index.
En bref
- Le robot lit les pages ; c’est le moteur qui décide ensuite de les indexer, puis de les classer.
- Il trouve les pages en suivant les liens : une page sans lien a peu de chances d’être découverte.
- On lui parle avec deux fichiers : le robots.txt (où ne pas aller) et le sitemap (où aller).
- Depuis 2023, les IA ont leurs propres robots, et les bloquer n’a pas les mêmes conséquences.
Définition : robot (ou spider, crawler, agent, bot)
Les robots des moteurs de recherche (aussi appelés spiders, crawlers, agents ou bots) sont des programmes qui parcourent en permanence toutes les pages du web pour indexer leurs contenus (textes, photos, vidéos, fichiers...)
Ces « robots » suivent les liens (internes et externes) pour trouver d’autres pages qu’ils vont visiter pour, à nouveau, indexer leurs contenus, suivre les liens qui s’y trouvent…
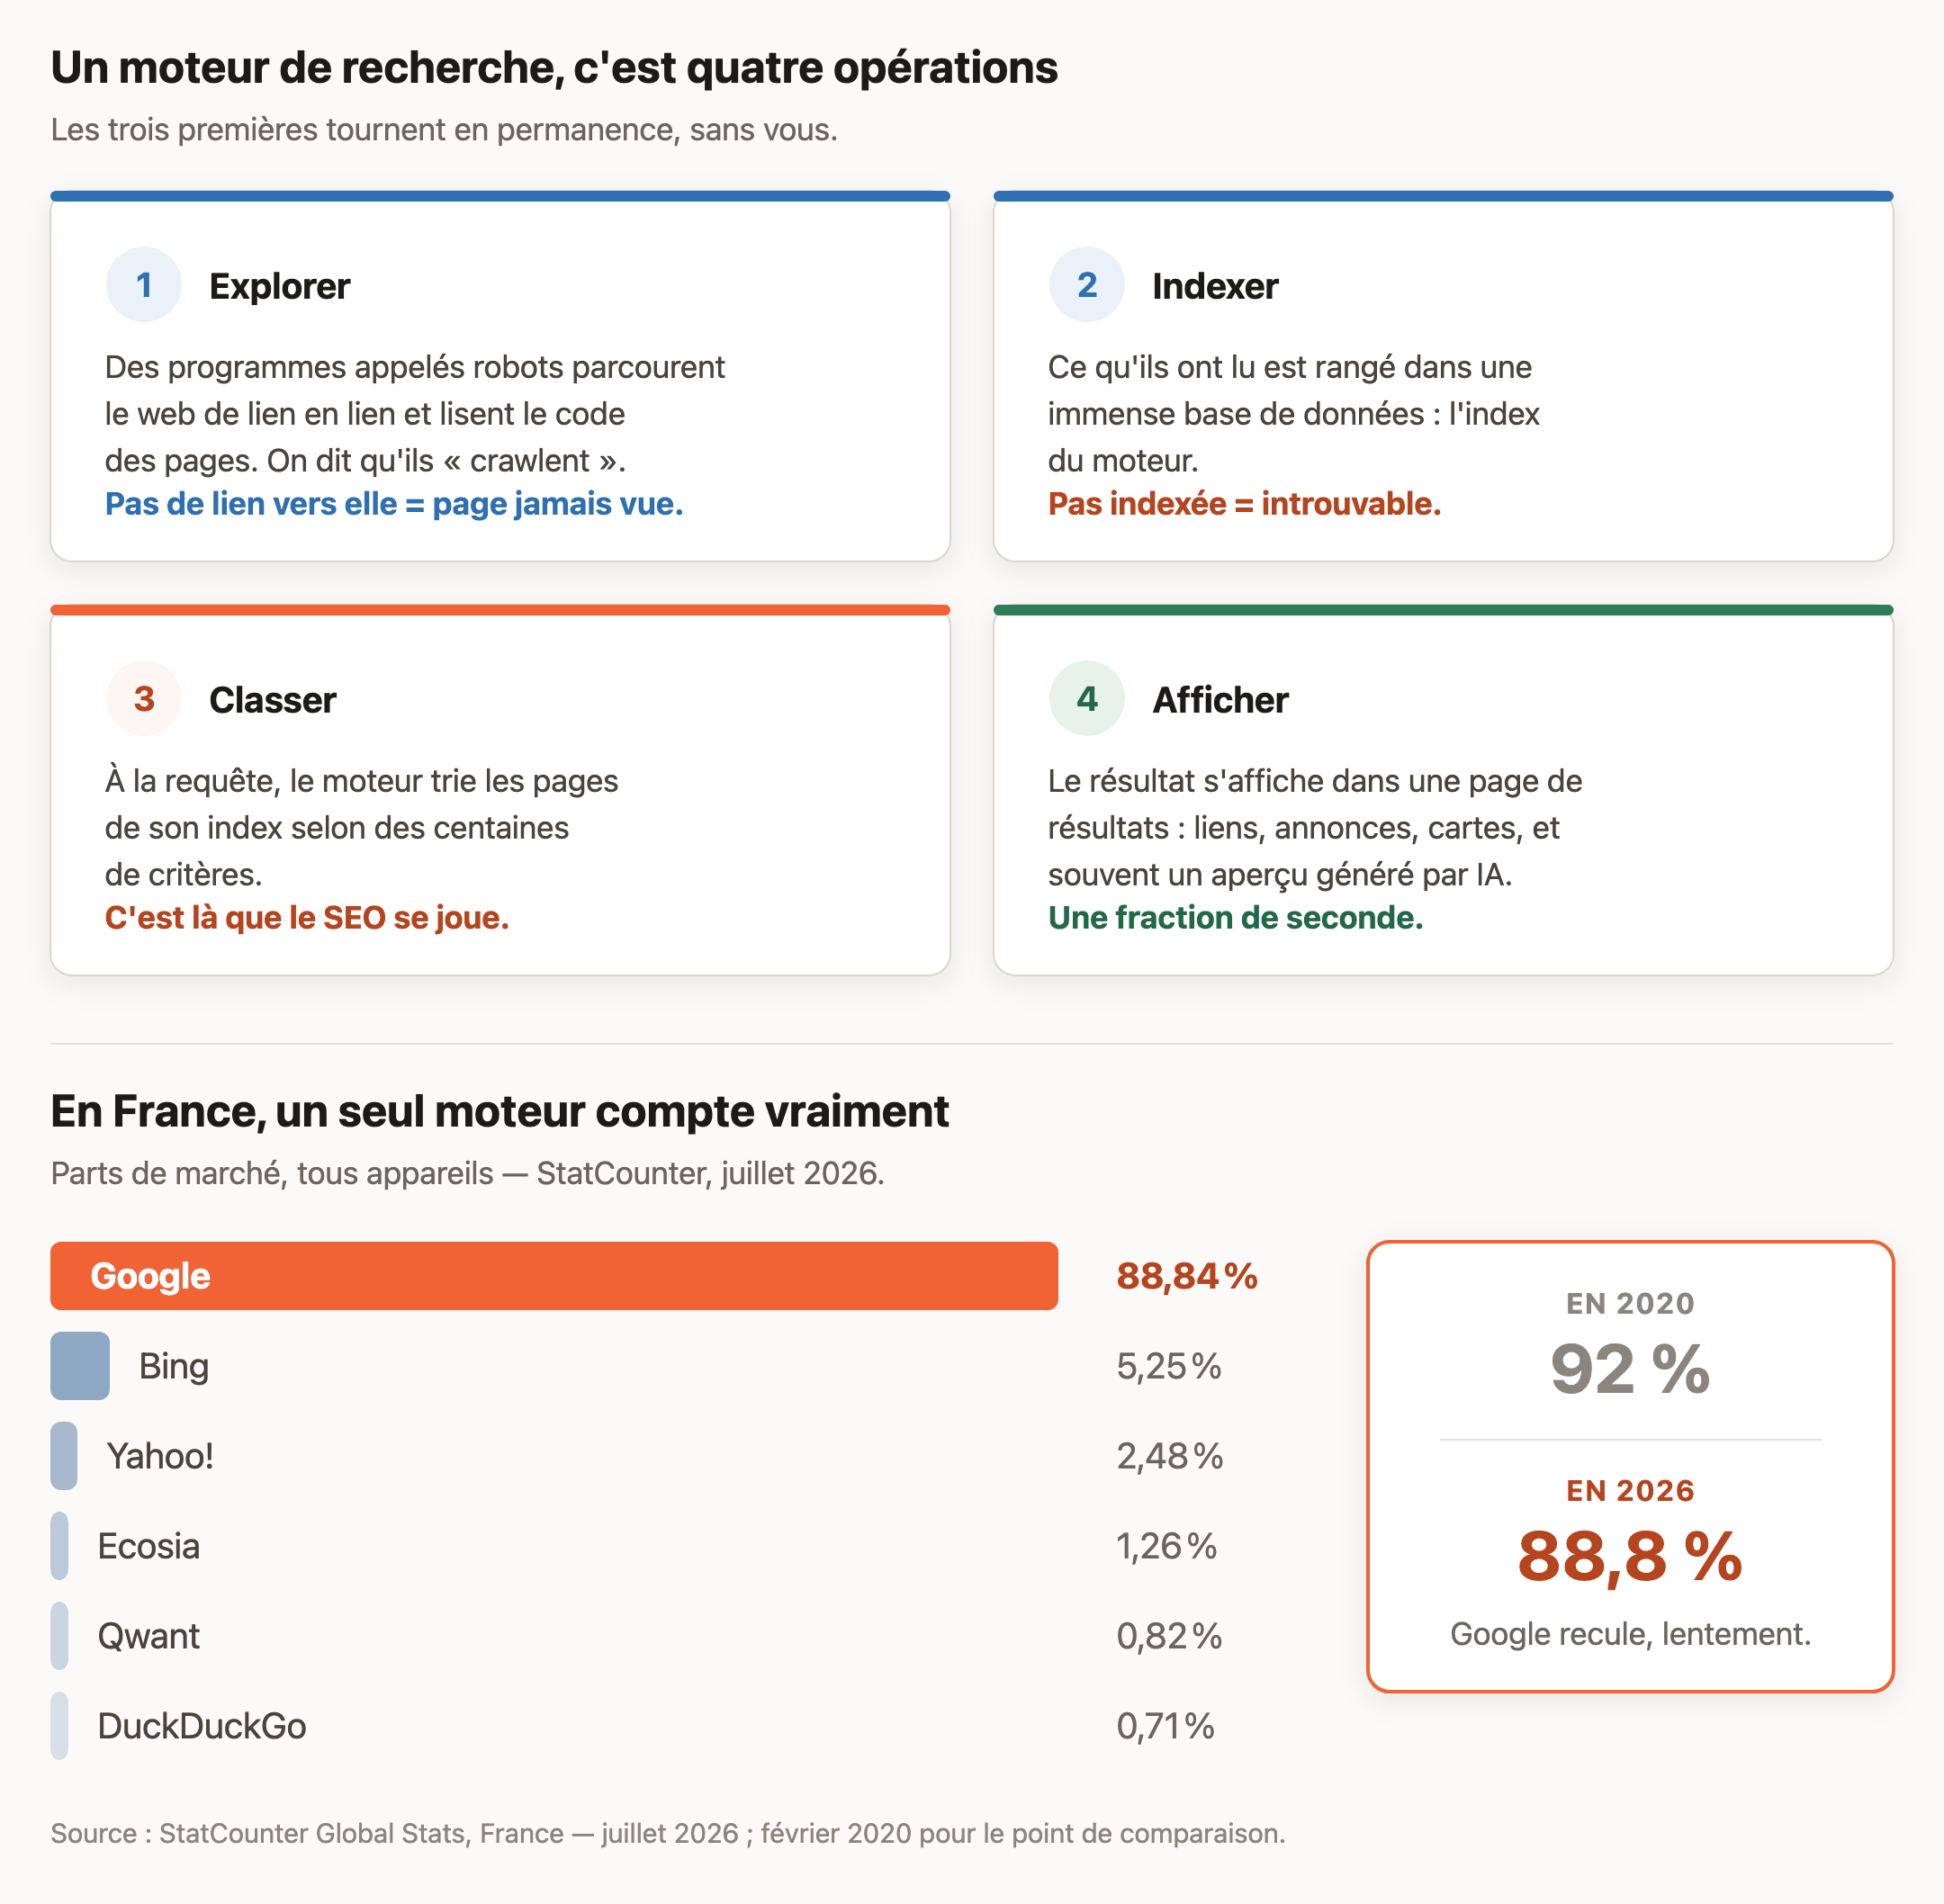
Une précision que je n’avais pas faite en 2011 : le robot lit, il ne décide pas. Il rapporte ce qu’il a trouvé ; c’est ensuite le moteur qui choisit de ranger la page dans son index, ou non, puis de la classer. Une page « crawlée » n’est donc pas forcément une page indexée. Le détail des quatre étapes est sur la fiche moteur de recherche.
Googlebot, Bingbot… qui sont ces robots ?
Chaque moteur a le sien, avec un nom qu’il annonce à chaque visite : Googlebot pour Google, Bingbot pour Bing. On les retrouve dans les journaux de connexion du serveur, et la Search Console de Google indique combien de pages Googlebot a explorées chaque jour.
Un point compte pour tous les sites : depuis le 5 juillet 2024, Google explore l’ensemble des sites avec la version smartphone de Googlebot. Autrement dit, c’est la version mobile de votre site que Google lit et juge. Un contenu absent sur mobile est, pour lui, un contenu qui n’existe pas.
Source : Google Search Central, juin 2024.
Comment le robot trouve vos pages
Par les liens, d’abord. Google l’écrit lui-même dans son guide de démarrage : la grande majorité des nouvelles pages qu’il découvre chaque jour, il les trouve en suivant des liens. C’est pour cela qu’un bon maillage interne compte autant : une page qu’aucun lien ne désigne (on parle de page « orpheline ») risque de ne jamais recevoir la visite du robot. Plus une page est éloignée de l’accueil en nombre de clics, plus elle est visitée rarement : c’est la notion de page profonde.
Par le sitemap, ensuite : un fichier qui liste les pages que vous souhaitez voir explorées. Il ne remplace pas les liens, il les complète.
Comment parler au robot : le fichier robots.txt
Le fichier robots.txt, placé à la racine du site, dit aux robots où ils ne doivent pas aller. Le principe a été inventé en 1994 par l’ingénieur néerlandais Martijn Koster, et il a fallu attendre septembre 2022 pour qu’il devienne une norme officielle d’Internet (RFC 9309). Les robots des grands moteurs le respectent ; c’est une consigne, pas une serrure.
Le piège classique : bloquer une page dans le robots.txt pour la faire disparaître de Google. Le robot ne peut alors plus la lire… ni lire la consigne qui demande de la retirer. Pour sortir une page des résultats, il faut au contraire la laisser lisible et y poser une balise « noindex ».
Source : IETF, RFC 9309, septembre 2022.
Le budget de crawl : faut-il s’en soucier ?
On entend souvent parler de « budget de crawl » : le nombre de pages qu’un robot accepte d’explorer sur un site dans un temps donné. Le sujet est réel, mais il concerne peu de monde. Google réserve son guide sur la question aux sites de plus d’un million de pages, ou de plus de 10 000 pages modifiées chaque jour, et précise que si vos pages sont explorées le jour même de leur publication, vous n’avez pas besoin de le lire.
Pour un site de PME de quelques centaines de pages, le problème n’est presque jamais le budget de crawl : c’est une page mal reliée, ou une page bloquée par erreur.
Source : Google Search Central, gestion du budget d’exploration (consulté le 7 octobre 2026).
Les nouveaux robots : ceux des IA
Depuis 2023, une autre famille de robots parcourt le web : ceux des intelligences artificielles. OpenAI a rendu public le sien, GPTBot, en août 2023. La subtilité, c’est qu’un même éditeur a souvent plusieurs robots aux rôles différents :
- chez OpenAI, GPTBot collecte des textes pour entraîner les modèles, tandis qu’OAI-SearchBot alimente la recherche de ChatGPT. Bloquer le premier n’empêche pas d’apparaître dans ChatGPT ; bloquer le second, si ;
- chez Google, la consigne Google-Extended permet de refuser que vos contenus servent à entraîner Gemini, sans aucun effet sur votre présence dans la recherche Google.
Un site qui bloque tous ces robots « par principe » peut donc disparaître des réponses des IA en croyant seulement refuser l’entraînement. Avant de toucher au robots.txt, il faut savoir lequel on vise : c’est un des points à vérifier dans un travail de visibilité dans les IA.
Sources : OpenAI, robots d’exploration ; Google, robots d’exploration courants (consultés le 7 octobre 2026).
Les erreurs fréquentes
- Croire que « crawlée » veut dire « indexée ». Le robot a lu la page ; le moteur peut très bien décider de ne pas la garder.
- Bloquer dans le robots.txt une page qu’on veut désindexer. Elle peut rester dans les résultats, sans description.
- Laisser des pages sans aucun lien en comptant sur le sitemap pour les faire découvrir.
- Bloquer tous les robots d’IA sans distinction, et perdre la visibilité dans leurs réponses en croyant seulement refuser l’entraînement.
Questions fréquentes
Qu’est-ce qu’un robot d’indexation ?
C’est un programme qui parcourt le web de lien en lien pour lire les pages et les transmettre à un moteur de recherche. On l’appelle aussi crawler, spider, bot ou agent. Le plus connu est Googlebot, celui de Google.
Quelle différence entre crawler et indexer ?
Crawler, c’est explorer : le robot visite la page et la lit. Indexer, c’est ranger : le moteur décide de garder la page dans sa base de données. Une page peut être explorée sans être indexée.
Comment empêcher un robot de visiter une page ?
Avec le fichier robots.txt, placé à la racine du site. Mais pour faire disparaître une page des résultats de Google, il faut au contraire la laisser accessible et y ajouter une balise noindex : un robot bloqué ne peut pas lire cette consigne.
Faut-il bloquer les robots des IA comme GPTBot ?
Cela dépend de ce que vous voulez éviter. GPTBot sert à entraîner les modèles d’OpenAI ; OAI-SearchBot sert à la recherche de ChatGPT. Bloquer le premier n’empêche pas d’être cité dans ChatGPT, bloquer le second, si. Chaque robot se règle séparément.
Vous avez besoin d’être plus visible sur le web ?
On en parle ?
Prenons rendez-vous ! À lire aussi sur le blog

E-réputation dans les IA : ce que ChatGPT, Copilot ou Gemini disent de votre entreprise
Être cité par une IA, c’est une chose. Ce qu’elle répond quand on lui demande « que penses-tu de cette entreprise ? », c’en est une autre. Comment tester votre e-réputation dans les IA, et quoi faire du résultat.

Citations IA : comment ChatGPT décide de vous citer (ou pas)
Les classements captent 40 % des citations des IA sur les questions d’achat. Pourquoi être premier sur son métier ne suffit pas, et comment se faire citer là où ChatGPT va vraiment chercher.

SEO : les années 20, les années folles
Pour tous les professionnels du search et du SEO la période que nous traversons est totalement folle. Intelligence artificielle, automatisation, no code, Google leaks, nouveaux comportements des utilisateurs... Je suis consultant depuis 2009. Jamais je n'avais du...